一次真实的服务器故障排查:从 Nginx 502 到 OOM、Swap 与 systemd 守护
一次真实的 502 故障复盘:沿公网、Nginx、8083、Java 进程与内核日志逐层定位,确认低内存、无 Swap 与高内存任务并发触发 OOM Killer;并说明 Swap、JVM 内存边界、systemd 守护及分层验收方法。...
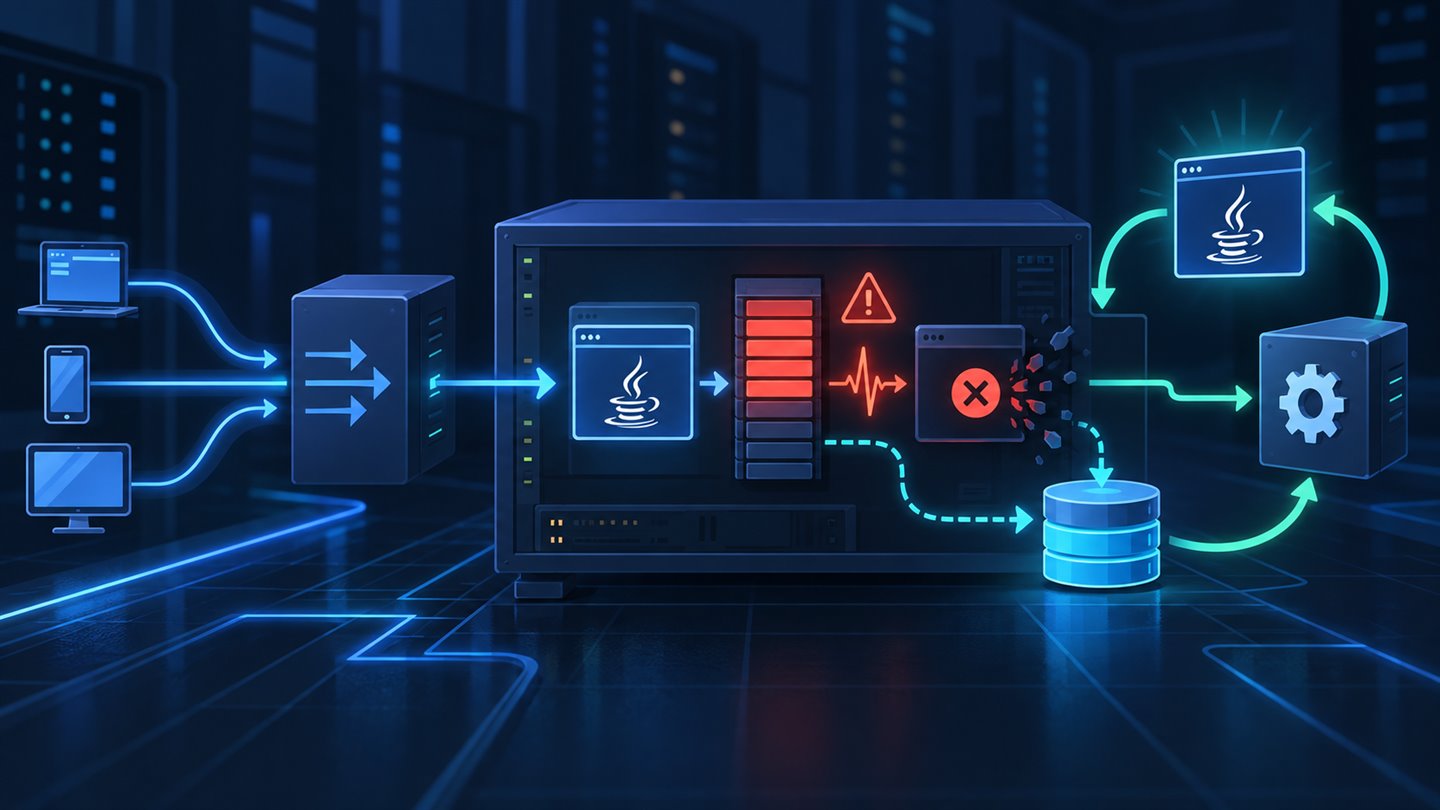
一次 502 故障,表面看是 Nginx 无法连接后端,真正的起点却在更底层:小内存服务器没有 Swap,系统更新任务与 Java 服务同时争抢内存,最终触发 Linux OOM Killer。本文按实际排查顺序,还原从请求链路、端口、进程到内核日志的完整定位过程,并说明 Swap、JVM 内存边界与 systemd 守护分别解决什么问题。
## 1. 背景
网站此前一直正常运行,随后突然无法访问。浏览器侧只能看到 502,直觉上很容易把问题归到 Nginx、证书或反向代理配置。
但 502 只说明网关没有从上游服务拿到有效响应。它是一个结果,不能直接说明故障发生在 Nginx。
这次排查遵循一个原则:沿真实请求路径逐层收窄范围,每一层都用状态、端口和日志验证,不用重启服务掩盖现场。
```text
公网请求
-> Nginx / HTTPS
-> upstream
-> 8083 端口
-> Java 进程
-> 系统资源
-> 内核日志
```
## 2. 故障现象
现场的关键现象可以归纳为四点:
1. 网站返回 502,无法正常访问;
2. Nginx 错误日志显示无法连接 upstream;
3. 后端约定的 8083 端口没有监听;
4. 原本应当运行的 Java 进程已经消失。
这四点构成了一条明确的方向:Nginx 仍然在接收请求,但它要转发的 Java 服务已经不可用。
## 3. 排查思路:从外到内定位
面对 502,先确认每一层承担的职责:
| 层级 | 需要确认的问题 | 典型证据 |
| --- | --- | --- |
| 公网与 HTTPS | 域名是否可达、TLS 是否正常 | HTTP 状态码、证书握手 |
| Nginx | 进程是否存活、配置是否有效 | `nginx -t`、error log |
| upstream | 代理目标是否正确、是否可连接 | `proxy_pass`、连接错误 |
| 应用端口 | 后端是否真正监听 | `ss -lntp` |
| Java 进程 | 应用是未启动还是异常退出 | `ps`、systemd 状态、应用日志 |
| 操作系统 | 是否发生资源耗尽或强制终止 | `free`、`journalctl -k`、OOM 记录 |
逐层检查的价值,在于区分“最先出错的地方”和“后续被连带影响的地方”。如果直接改 Nginx 或反复重启 Java,可能短暂恢复,却无法解释服务为什么会再次消失。
## 4. 检查 Nginx:502 是结果
Nginx 错误日志中出现了类似下面的信息:
```text
connect() failed (111: Connection refused) while connecting to upstream
```
`Connection refused` 的含义很具体:Nginx 已经尝试连接代理目标,但目标端口当时没有程序接受连接。此时 Nginx 本身仍能工作,否则客户端通常不会拿到由它返回的 502。
因此,下一步不是立即修改反向代理配置,而是确认 upstream 对应的端口:
```bash
ss -lntp | grep 8083
curl --max-time 5 http://127.0.0.1:8083/
```
现场检查发现 8083 没有监听,本机请求也无法建立连接。至此可以确认:Nginx 502 是后端不可用造成的连锁结果。
## 5. 检查 Java 与 8083
继续检查 Java 进程时,发现应用进程已经不存在。这个结果与端口状态完全吻合:
```text
Java 进程退出
-> 8083 监听消失
-> Nginx 无法连接 upstream
-> 客户端收到 502
```
接下来最重要的问题变成:Java 为什么退出?
如果应用日志中没有完整的业务异常栈,而进程像“突然消失”一样终止,就不能只盯着应用日志。进程可能不是自己退出,而是被操作系统终止。此时需要继续查看 systemd、journal 和内核日志。
## 6. 找到 OOM 证据
内核日志给出了决定性证据:系统曾发生内存不足,并由 OOM Killer 终止 Java 进程。脱敏后的核心语义如下:
```text
Out of memory: Killed process <pid> (java)
```
OOM 是 Out Of Memory 的缩写。当物理内存已经不足,系统又没有足够的可回收内存或 Swap 可用时,Linux 内核必须主动结束一个或多个进程,释放资源以避免整台机器完全失去响应。这一机制就是 OOM Killer。
Java 服务通常会保留堆、线程栈、元空间、直接内存和本地库等多类内存。在小内存机器上,它容易成为占用较大的进程,因此在内存竞争激烈时可能被 OOM Killer 选中。进程被内核直接发送终止信号后,不一定来得及在应用日志里留下正常的关闭记录,于是看起来就像“突然消失”。
这也是内核日志不可替代的原因:应用日志解释应用内部发生了什么,而内核日志能够解释操作系统对进程做了什么。
## 7. 真正根因与故障链路
结合当时的资源状态和日志,真正的故障链路是:
```text
物理内存较低
+ 当时没有配置 Swap
+ dnf 等高内存任务与 Java 并发运行
+ Java 本身占用较多内存
|
v
可用内存耗尽
|
v
Linux OOM Killer 介入
|
v
Java 被杀死
|
v
8083 监听消失
|
v
Nginx 连接 upstream 被拒绝
|
v
网站 502
```
Java 退出后没有可靠的进程守护,服务也没有自动恢复,这让一次瞬时资源峰值演变成持续不可用。
排查过程中还验证了 Nginx、SSL、数据库、Redis、磁盘空间和业务源码。它们没有提供能够解释“Java 进程被内核杀死”的首要证据,因此不属于本次事故的根因。这里需要特别注意:排除首要根因,不代表这些模块永远没有风险,只代表它们不是这次故障链最早的触发点。
## 8. Swap 的作用:缓冲,而不是扩容
Swap 是磁盘上的交换空间。当物理内存紧张时,内核可以把暂时不活跃的内存页换出,为突发任务留出缓冲。
对于小内存服务器,合理的 Swap 可以降低短时峰值直接触发 OOM 的概率。例如系统更新、依赖解析或构建任务突然增加内存占用时,Swap 能给服务留下更多反应时间。
但 Swap 不能替代 RAM:
| 对比项 | 物理内存 | Swap |
| --- | --- | --- |
| 介质 | RAM | 磁盘或云盘 |
| 速度 | 快 | 明显更慢 |
| 适合用途 | 正常工作集 | 突发峰值缓冲 |
| 长期高占用 | 需要评估容量 | 往往意味着内存不足或参数不合理 |
修复后既要确认 Swap 已启用,也要继续观察它是否长期大量使用。若 Swap 持续增长并伴随频繁换页,应用虽然暂时没有被杀死,响应时间仍可能显著恶化,此时应该优化内存或扩容,而不是继续增加 Swap 掩盖问题。
常用观察命令包括:
```bash
free -h
swapon --show
vmstat 1
```
## 9. 为 JVM 设置合理的内存边界
只增加 Swap 还不够。生产环境中的 Java 服务应根据机器总内存、同机服务和峰值任务,设置合理的 JVM 内存边界。
- `-Xms`:JVM 初始堆大小;
- `-Xmx`:JVM 最大堆大小。
下面只是语法示意,并非本次服务器的实际参数:
```bash
java -Xms256m -Xmx768m -jar app.jar
```
`-Xmx` 不能简单设置成机器全部内存,因为 Java 进程除堆外还会使用元空间、线程栈、直接内存等,操作系统、Nginx、数据库客户端和运维任务也需要内存。合理做法是先保留系统安全余量,再结合 GC 日志、进程 RSS、并发量和真实负载调整。
如果仅限制堆,却忽略堆外内存和同机任务,仍然可能发生系统级 OOM。
## 10. 使用 systemd 守护 Java 服务
OOM 的根因需要通过资源治理解决,但进程守护同样不可缺少。systemd 可以提供:
- 开机自动启动;
- 异常退出后的自动恢复;
- 统一的状态查询和日志入口;
- 明确的运行用户、工作目录和启动参数。
下面是经过匿名化的示例,路径和 JVM 参数需要按实际环境调整:
```ini
[Unit]
Description=Blog Java Service
After=network.target
[Service]
Type=simple
User=blog
WorkingDirectory=/opt/blog
ExecStart=/usr/bin/java -Xms256m -Xmx768m -jar /opt/blog/app.jar --spring.profiles.active=prod
Restart=on-failure
RestartSec=5
SuccessExitStatus=143
[Install]
WantedBy=multi-user.target
```
`Restart=on-failure` 表示进程因非正常退出、信号或超时失败时由 systemd 尝试恢复。它能缩短故障持续时间,但不是 OOM 的治疗方案:如果内存问题持续存在,服务仍可能进入“启动—被杀—再启动”的循环,所以还要结合重启次数、内核 OOM 日志和资源曲线判断是否真正稳定。
常用管理与诊断入口如下:
```bash
systemctl status blog.service
journalctl -u blog.service --since today
systemctl show blog.service -p NRestarts -p MainPID
```
## 11. 修复后的分层验收
恢复服务不等于完成修复。本次验收按请求链路逐层进行:
- Java 进程持续存在,systemd 显示服务处于 active;
- 8083 正常监听;
- 服务器本机访问应用成功;
- 公网访问返回 HTTP 200;
- Nginx 不再出现连接 8083 被拒绝的新日志;
- Java 由 systemd 管理,异常退出后具备自动恢复能力;
- Swap 已正常启用;
- 修复后没有出现新的 OOM 事件;
- Swap 没有长期大量占用。
其中,24–72 小时的内存、Swap 和重启次数仍属于持续观察项,不能在观察窗口结束前宣称长期稳定。建议至少记录以下指标:
```text
Java RSS / JVM 堆使用率
可用内存与 Swap 使用量
系统 load 与磁盘 I/O wait
systemd NRestarts
内核 OOM 事件
Nginx upstream 失败次数
```
只有“服务在线、资源趋势稳定、没有新增 OOM、没有反复重启”同时成立,才能认为修复不是一次临时恢复。
## 12. 经验总结
这次故障留下了几条值得复用的经验:
1. 502 不一定是 Nginx 故障,它更常见的含义是网关无法从上游得到响应;
2. 应沿公网、代理、端口、进程、系统资源和内核日志逐层定位;
3. 要区分表面现象、连锁错误和最早的根因;
4. 应用日志没有异常退出栈时,要检查 systemd 与内核日志;
5. 小内存服务器必须为系统和突发任务预留安全余量;
6. Swap 是应对峰值的保险,不是物理内存扩容;
7. JVM 需要合理的内存边界,但不能只关注 Java 堆;
8. 生产服务必须由可靠的进程管理器守护;
9. 修复后要从进程、端口、本机请求、公网请求和资源趋势逐层验收。
一句话总结:**Nginx 502 只是故障出口,真正的修复必须沿链路找到让 upstream 消失的第一张证据。**
