Codex 能做什么?从 AI 编程助手到真正帮你完成工作的智能 Agent
Codex 的价值不只在于生成代码,而是能在授权范围内理解项目、制定计划、修改文件、执行命令、运行测试并根据结果持续修复。本文结合博客首页改造、Java 服务器排障和安全 Bug 修复三个案例,说明普通人、开发者与网站维护者如何安全地把想法推进到可验证的结果。...
Codex 的价值不只在于生成代码,而是能在授权范围内理解项目、制定计划、修改文件、执行命令、运行测试,并根据结果持续修复。本文结合博客首页改造、Java 服务器排障和安全 Bug 修复三个案例,说明普通人、开发者与网站维护者如何安全地把想法推进到可验证的结果。
*图 1:人类负责目标、边界和关键判断,Codex 在授权范围内连接代码、终端、测试与页面结果。*
以前我维护一个网站,如果想改首页、给文章增加封面、调整阅读页面,再顺手排查一次 Java 服务异常,往往要在 IDE、终端、服务器和浏览器之间来回切换。
需求要自己拆,文件要自己找,CSS 和模板要自己改,项目要自己启动,页面要自己检查;如果测试失败,还得回到代码里继续追。每一步都不算神秘,但它们会不断打断思路,也会把一个本来很清楚的目标拆成很多零碎操作。
现在,我可以先把目标直接说出来:
> 帮我检查整个博客项目,分析首页目前存在的问题,在不破坏原有功能的情况下重新设计首页,并给每篇文章增加封面图片。完成后运行测试,检查桌面端和移动端效果,再把修改和风险告诉我。
这句话和“帮我写一段首页 CSS”看起来差别不大,背后的工作方式却完全不同。Codex 可以先阅读仓库说明,搜索相关代码,理解页面如何取得文章数据,再修改多个文件、运行命令、查看测试结果,发现问题后继续调整。
过去常见的模式是:
```text
我问问题 → AI 给答案 → 我自己执行
```
而 Agent 式的工作逐渐变成:
```text
我描述目标 → Codex 理解项目 → 制定计划 → 执行 → 测试
→ 观察结果 → 修复 → 再验证 → 汇报
```
这篇文章不打算把 Codex 写成一个万能产品。我更想从普通用户、程序员、独立开发者和网站维护者的视角,看看它在哪些地方真的能省事,哪些地方仍然必须由人来把关。
[TOC]
## 1. Codex 到底是什么?
如果用一句普通人能听懂的话解释:
**普通聊天 AI 更像坐在旁边告诉你应该怎么修的技术顾问;Codex 更像坐到电脑前,在获得权限后可以阅读项目、打开文件、执行命令、修改代码、运行测试,并根据结果继续调整的技术搭档。**
这里最关键的词不是“代码”,而是“行动”。
当 Codex 连接到一个项目和相应工具后,它能做的通常包括:
- 阅读目录和多个源文件,追踪一次请求经过 controller、service、mapper 到数据库的调用链;
- 在仓库里搜索代码,定位某个页面、接口或异常真正对应的位置;
- 修改一个或多个文件,增加功能、修 Bug、重构重复逻辑;
- 执行构建、测试、格式检查和其他终端命令;
- 读取错误输出与日志,根据新证据继续排查;
- 开发前端页面,并在支持的环境中结合浏览器或页面预览检查效果;
- 检查 Git diff、审查未提交修改,参与分支、提交和 PR 工作流;
- 通过 Skills 复用一套稳定的工作流程;
- 在适合拆分时让多个 Agent 并行探索、测试或审查,再汇总结果;
- 处理文档、表格、数据分析、报告和其他知识工作;
- 在具备相应工具与授权时生成图片、整理素材或自动执行重复任务。
这些能力并不是在每个客户端、每个账号或每个项目里无条件全部可用。实际能力取决于你使用的 Codex 形态、连接的工具、沙箱权限、网络权限和审批规则。OpenAI 官方资料目前把 Codex 覆盖到桌面端、CLI、IDE 与云端等形态,并单独列出了文件、浏览器、代码审查、Skills、长时间任务等工作流;具体可用性仍应以你当前界面为准。可参考 [Codex 功能概览](https://learn.chatgpt.com/docs/features) 与 [Codex 使用案例](https://learn.chatgpt.com/use-cases)。
*图 2:Codex 的重点不是多写几行代码,而是围绕结果把理解、执行和验证连起来。*
## 2. Codex 和普通 AI 对话最大的区别
把二者简单地分成“一个会写代码、一个不会写代码”并不准确。普通聊天 AI 也能解释代码、生成示例,甚至给出很好的方案。真正的差异在于:**答案能不能进入真实环境,并形成反馈闭环。**
| 对比项 | 普通 AI 对话 | Codex |
| --- | --- | --- |
| 理解整个项目 | 通常只理解你粘贴的片段和对话上下文 | 在授权的工作区内可搜索目录、读取相关文件并建立项目上下文 |
| 读取多个文件 | 需要人工逐个提供,容易缺上下文 | 可主动定位并读取完成任务所需的多个文件 |
| 修改代码 | 通常给出建议或代码片段 | 可直接生成补丁并修改工作区文件 |
| 运行命令 | 通常只能告诉你运行什么 | 可在受控终端中执行构建、脚本和诊断命令 |
| 执行测试 | 给出测试代码或测试思路 | 可运行测试并读取真实通过、失败结果 |
| 处理长期任务 | 容易在多轮复制信息中丢失进度 | 支持围绕清晰目标和完成标准持续推进,能力依客户端而异 |
| 同时处理多个任务 | 通常在一条对话里顺序处理 | 可把独立工作交给并行子 Agent,再汇总结果 |
| 根据执行结果继续修复 | 需要人把错误复制回来 | 可观察命令或测试输出,继续修改并再次验证 |
| 适合大型项目 | 上下文常依赖人工挑选 | 更适合做仓库搜索、调用链追踪和跨文件修改,但仍需控制范围 |
| 自动化重复工作 | 多提供步骤或模板 | 可借助 Skills、脚本和定时/长期工作流复用过程 |
*图 3:Chat AI 更擅长给出答案;Codex 更进一步,把答案带入真实项目并根据执行结果继续行动。*
所以,我更愿意把 Codex 的核心过程概括为:
```text
理解 → 计划 → 执行 → 验证 → 修改 → 再验证
```
这也是为什么它更像 Agent,而不只是一个聊天框。
## 3. 实际案例一:让 Codex 改造我的博客首页
以这个博客已经完成的一次首页改造为例。它不是一个只有静态 HTML 的演示站,而是 Maven 构建的 Spring Boot 项目:后端通过 MyBatis 读取文章,Thymeleaf 渲染首页,正文由 Editor.md 展示。
目标很具体:
- 优化首页整体视觉风格;
- 改善文章列表和卡片布局;
- 给每篇文章增加封面;
- 拉开标题、摘要、分类、日期和标签的信息层级;
- 改善移动端体验;
- 尽量不改变原来的文章发布与查询逻辑。
传统开发时,我会依次做需求分析、查找首页模板、确认数据接口、改 HTML、改 CSS、启动项目、打开浏览器、发现问题,再回到代码继续改。流程大致如下:
```text
需求 → 人工找文件 → 修改代码 → 运行 → 浏览器检查
↓
发现问题 → 再修改
```
让 Codex 参与后,真正有用的不是让它立刻输出一大段页面代码,而是先让它回答四个问题:
1. 首页入口在哪里?
2. 文章数据从哪里来?
3. 封面应该存进数据库,还是能从现有正文里取得?
4. 哪些测试可以证明旧功能没有被破坏?
在当前仓库里,答案分别落到了这些真实文件:
- `templates/index.html`:首页结构和文章卡片;
- `static/css/site.css`:桌面端、平板和移动端布局;
- `PublicSiteController`:首页所需的最新文章与分类数据;
- `ArticleCoverUtil`:从文章正文第一张有效图片提取封面;
- `HomePageTemplateTests` 与 `ArticleCoverUtilTests`:验证封面、占位卡片、懒加载和安全 URL。
这个选择很重要。项目原本没有独立 `cover` 字段,如果为了封面直接改数据库表、补 migration、改发布接口,会把一次首页改版扩大成数据结构迁移。现在的方案是从正文第一张合法图片动态提取 `articleCover`,首页卡片只消费这个展示字段;没有图片时使用分类占位卡片。原来的文章写入流程和公开 URL 都不需要改变。
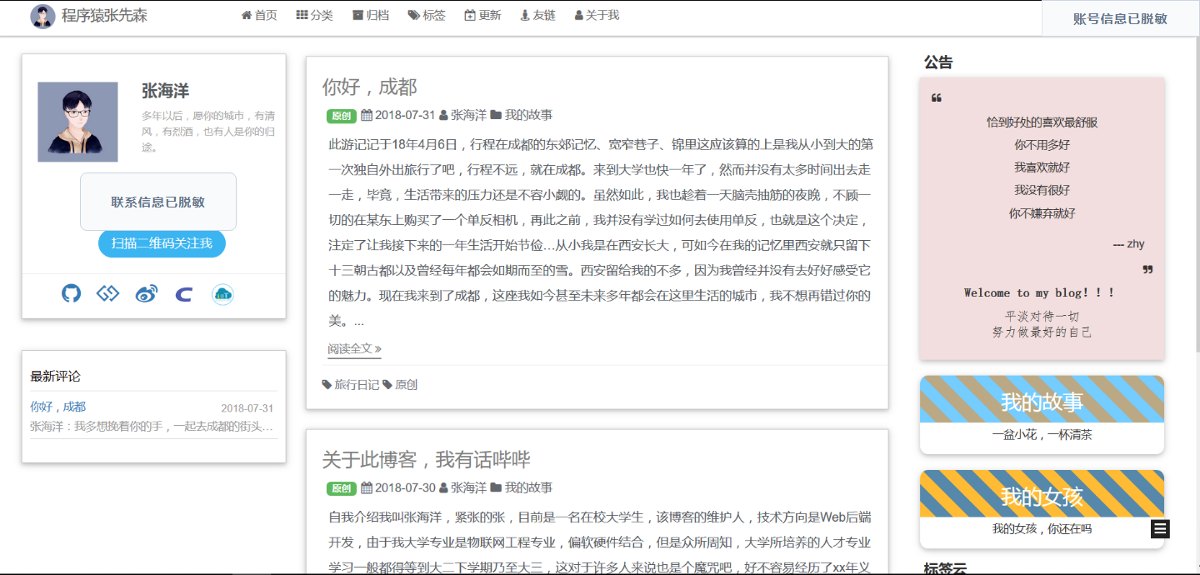
*图 4:项目 README 中保存的旧版首页。多栏信息密度高,文章列表缺少统一封面,截图中的联系信息已脱敏。*
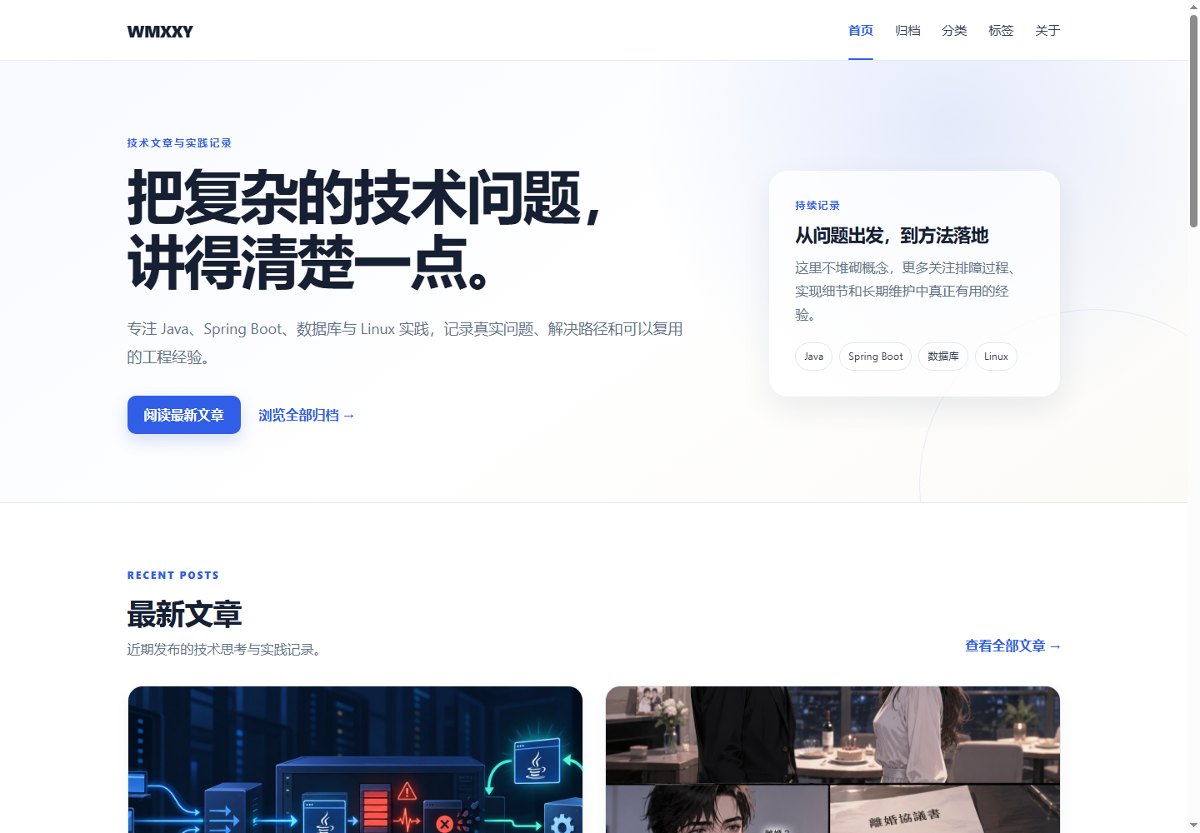
*图 5:2026 年 9 月 14 日获取的当前公开首页。新版突出主标题、文章封面、摘要与分类层级,并使用响应式卡片布局。*
最终效果不是“换了一套颜色”这么简单,而是同时完成了数据来源确认、最小范围改造、封面兜底、图片懒加载、移动端断点和模板测试。Codex 在这里扮演的角色,更接近一个能沿着项目结构把设计目标落实下去的开发搭档。
## 4. 实际案例二:Codex 帮助排查服务器故障
这个博客还保存了一篇真实的服务器故障复盘:[一次真实的服务器故障排查:从 Nginx 502 到 OOM、Swap 与 systemd 守护](/article/1789288493)。当时的架构可以简化为:
*图 6:用户请求经过 Nginx 到监听 8083 的 Java 服务,应用再访问 MySQL 与 Redis。*
网站突然打不开时,最容易犯的错误是看见 502 就立即重启 Nginx,或者随手修改代理配置。更稳妥的做法是先给 Codex 一个只读诊断任务:
> 帮我检查服务器为什么网站打不开。先不要修改任何配置,只进行诊断。检查 Java 进程、8083 端口、Nginx、systemd、内存、OOM、Swap 和相关日志,然后给出根因分析、证据链与建议;没有我的确认不要执行修复。
传统排查通常需要自己逐条执行:
```bash
ps -ef | grep java
ss -lntp | grep 8083
nginx -t
systemctl status blog.service
journalctl -u blog.service --since today
journalctl -k --since today
free -h
swapon --show
```
Codex 的作用不是把这些命令“背”出来,而是把输出串成因果链:Nginx 是否还活着、upstream 为什么拒绝连接、8083 是否监听、Java 是没启动还是被终止、应用日志有没有异常栈、内核是否记录了 OOM Killer。
*图 7:从网站不可访问开始,沿 Nginx、端口、进程、服务管理和系统资源逐层收集证据。*
在这次真实故障中,关键证据最终指向:小内存环境没有 Swap,高内存任务与 Java 同时争抢内存,Linux OOM Killer 终止了 Java;8083 随之消失,Nginx 才返回 502。换句话说,502 是故障出口,不是根因。
*图 8:日志示意只保留排障所需语义,不包含 IP、账号、目录、Cookie、Token 或其他凭据。*
这里必须强调一条边界:**不要让 AI 一上来就改服务器。**
推荐顺序是:
```text
检查 → 收集证据 → 分析 → 给出方案 → 用户确认 → 再执行修改
```
尤其是生产环境中的服务重启、JVM 参数、systemd 配置、Swap、Nginx、数据库和防火墙,都应保留人工确认。诊断可以尽量自动化,变更必须匹配风险等级。
## 5. 实际案例三:让 Codex 修复一个 Bug
再看一个来自当前仓库、足够小但很真实的例子:首页会从 Markdown 正文中提取第一张图片作为封面。如果正文里出现下面这种不安全地址:
```markdown

```
正确结果不是把它原样送进 `<img src>`,而是拒绝这个地址并使用首页占位图。这个行为在 `ArticleCoverUtilTests` 里有明确测试:
```java
assertNull(ArticleCoverUtil.findFirstImageUrl(
""));
```
如果测试失败,Codex 可以搜索 `ArticleCoverUtil` 的调用位置,确认允许的 URL 规则,修改实现,运行 `mvn test`,查看失败信息,再继续修复。与此同时,它还要确认正常的 `https://...` 图片和站内 `/...` 路径仍然能够提取,避免修复安全问题时误伤正常封面。
*图 9:理解、计划、编码、运行、测试、观察、修复与验证构成 Agent Loop。*
真正有价值的地方,并不是 Codex 第一次就一定写对。软件开发本来就充满未知,第一次修改不通过很正常。Agent 的价值在于它能够进入循环:
```text
发现问题 → 修改 → 测试 → 查看结果 → 再修改 → 验证
```
只要测试和完成标准写得足够清楚,这个循环就比“生成一段看起来正确的代码”可靠得多。
## 6. 不会编程的人能不能使用 Codex?
可以,但“可以使用”和“可以完全不理解结果”是两回事。
假设一个不会编程的人说:
> 我想做一个个人网站,首页展示我的文章,有文章封面、分类、搜索、深色模式和移动端适配。
过去,他可能要先学习 HTML、CSS、JavaScript、某个框架、Git 和部署,过很久才能看到第一版。现在 Codex 可以先帮他拆解需求:哪些是页面,哪些是数据,搜索是前端过滤还是后端检索,文章存在哪里,部署到什么环境;然后创建项目、编写页面、增加功能、修改设计、修复错误,并输出部署说明。
一个更容易得到好结果的提问方式是:
> 先做一个可以在本地运行的个人网站。请先列出页面和数据结构,再实现首页、文章详情、分类、搜索、深色模式和移动端适配。每完成一部分就运行检查。不要购买域名、不要部署公网,也不要删除我已有的文件。
这段话做了三件事:给出目标,限定第一阶段,明确禁止事项。它不需要用户会写代码,却要求用户知道自己想要什么。
Codex 降低了技术门槛,但用户仍然需要判断:页面是不是自己想要的,搜索结果对不对,数据是否会丢失,部署是否安全,费用是否可接受。不会编程的人可以把 Codex 当作技术搭档,但不能把“我看不懂”当作“结果一定正确”。
## 7. Codex 可以改善我们的哪些工作?
我认为,它带来的变化主要不是多了几个按钮,而是工作分配方式发生了变化。
第一,减少重复劳动。搜索同名方法、批量修改引用、补测试、整理文档、执行固定检查,这些工作重要但机械,适合交给 Agent。
第二,降低陌生项目的理解成本。面对一个从没见过的 Spring Boot 仓库,可以先让 Codex画出入口、依赖和调用链,人再从关键节点深入,而不是从第一个目录开始盲读。
第三,降低尝试新技术的门槛。你不必先记住所有命令,Codex 可以搭建最小样例、运行它、解释失败原因;学习从“先读完再动手”变成“在可验证的小实验中理解”。
第四,让一个人能处理原来需要多个工具来回配合的任务。代码、终端、测试、Git、页面预览和文档可以放进同一条任务链,减少上下文切换。
第五,让开发者把更多时间放在架构、产品、设计和决策上。重复实现被压缩后,人更应该关注边界条件、长期维护、用户体验和风险。
第六,让非程序员完成一部分过去必须依赖程序员的技术工作,例如做内部小工具、清洗表格、生成可运行的页面原型、整理站点内容。但涉及生产系统时,仍应由具备相应责任和能力的人审核。
*图 10:人的角色从操作每一步,转向定义目标、规则和完成标准,再检查 Agent 交付的结果。*
复杂任务还可以进一步拆开。例如,让一个 Agent 探索代码结构,一个运行测试,一个分析日志,一个检查安全与文档,最后由主 Agent 合并证据。OpenAI 官方文档把这种方式称为 subagent workflow,同时也提醒并行写同一批文件容易产生冲突,因此更适合先用于探索、测试、分类和审查。参见 [Subagents 官方说明](https://learn.chatgpt.com/docs/agent-configuration/subagents)。
*图 11:把可独立的工作并行展开,再由主 Agent 汇总;写操作重叠时要控制范围。*
## 8. Codex 最适合做什么?
*图 12:Codex 的能力从代码延伸到工具执行、协作自动化与知识工作,但始终受权限和环境约束。*
下面这些任务通常很适合交给 Codex,但最好都给出明确的完成标准:
- **代码开发**:给现有 Spring Boot 博客增加文章搜索接口,并补充对应测试。
- **Bug 修复**:根据异常栈定位空指针来源,做最小修改并运行回归测试。
- **项目重构**:把重复的参数校验收敛到公共组件,同时证明接口行为不变。
- **代码审查**:检查当前 Git diff 是否存在正确性、安全性或测试覆盖问题。官方 `/review` 工作流支持审查分支、提交或未提交修改,并默认不改工作区;参见 [代码审查文档](https://learn.chatgpt.com/docs/code-review)。
- **测试**:为封面提取规则补正常地址、站内路径和恶意协议三个边界用例。
- **网站开发**:从首页卡片到移动端断点一起实现,然后用真实页面检查视觉效果。
- **数据处理**:清洗 CSV 中的重复记录,保留原文件并输出变更统计。
- **服务器辅助诊断**:只读检查进程、端口、代理、内存与日志,形成证据链后再提方案。
- **技术文档**:根据代码和配置更新部署文档,同时标出仍需人工确认的环境差异。
- **Git 工作流**:整理变更、解释 diff、准备提交说明或 PR 描述;推送前由人确认。
- **重复任务自动化**:把固定的发布检查、CI 故障诊断或周报整理做成可复用 Skill。官方定义的 Skill 可以包含说明、资源和可选脚本,用来稳定复用一套任务流程;参见 [Skills 文档](https://learn.chatgpt.com/docs/build-skills)。
- **项目分析**:快速回答“登录请求经过哪些类”“这个字段在哪里写入”“删除接口有哪些调用者”。
- **原型开发**:从一句产品想法开始,做出能运行、能点击、能继续迭代的第一版。
长任务也并不等于“丢下一句话就不用管”。官方对长时间工作的建议同样强调清晰的结果、约束和完成标准,并让相关工作留在同一上下文里持续推进。参见 [Long-running work](https://learn.chatgpt.com/docs/long-running-work)。
## 9. Codex 不是什么
这部分比能力清单更重要:**Codex 不是永远不会犯错的程序员,也不是获得权限后就应该随意行动的自动化脚本。**
它可能会:
- 理解错需求,把“调整样式”做成“重写页面”;
- 修改错误文件,或者只修了表面现象;
- 执行命令失败,却误判任务已完成;
- 生成看起来合理、实际不符合业务规则的结果;
- 遗漏并发、权限、兼容性和异常输入等边界情况;
- 在缺少真实环境证据时,给出听起来完整但未经验证的推断。
因此,自动化程度应该和风险匹配:
| 风险等级 | 例子 | 建议方式 |
| --- | --- | --- |
| 低风险 | 搜索代码、解释日志、生成草稿、运行只读检查 | 可以提高自动化程度,保留结果复核 |
| 中风险 | 修改业务代码、升级依赖、批量改文件、创建提交 | Agent 执行 + 测试 + Git diff 人工审查 |
| 高风险 | 生产服务器、数据库写入、删除操作、权限与安全配置、部署、强制 Git 操作 | AI 分析 + 人工确认 + 小步执行 + 回滚与验收 |
尤其要警惕这些操作:生产数据库写入、递归删除、权限修改、防火墙与认证配置、`git push --force`、覆盖线上文件、重启关键服务。一个成熟的 Codex 使用方式,不是给它无限权限,而是设计好沙箱、允许范围、审批点和验证标准。
## 10. 普通人和开发者分别可以怎样开始?
普通人可以从低风险、能看到结果的任务开始:整理一批文档、分析表格、制作个人网站原型、改一个静态页面、生成部署说明。提示里尽量写清“我要得到什么”“哪些东西不能动”“怎样算完成”。
例如:
> 把这份杂乱的 CSV 整理成可读报表。不要修改原文件;输出一份新文件,并告诉我删除了多少重复行、哪些字段仍然缺失。
开发者则可以直接把完成标准交给 Codex:相关测试、兼容版本、性能边界、不可修改模块和 Git 范围。比起只说“修一下这个 Bug”,下面的说法更可靠:
> 修复文章封面解析中的不安全 URL 问题。只修改封面解析和对应测试;保留 HTTPS 与站内根相对路径;运行相关单测和完整测试,最后给出 diff 摘要与未覆盖风险。
网站维护者处理生产问题时,再加一句常常能避免很多麻烦:
> 第一阶段只诊断,不做写操作、不重启服务、不改配置。先提交证据和方案,等我确认。
这些并不是“提示词技巧”,而是在定义合作边界。目标越清楚,Agent 越容易做出可验证的结果。
## 11. 我认为 Codex 真正改变的是什么?
AI 编程真正重要的变化,可能并不是代码写得更快了,而是一个人能够完成的事情变多了。
过去,一条从想法到上线的路径往往是:
```text
想法 → 学习技术 → 写代码 → 调试 → 部署 → 维护
```
现在,它正在逐渐变成:
```text
想法 → 描述目标 → AI 执行 → 人类判断
↑ ↓
└── AI 继续执行 ──┘
↓
最终结果
```
人的角色并没有消失,反而更集中:提出值得做的目标,定义规则,做关键决策,识别风险,判断最终结果是否真的好。
如果目标含糊,Agent 可能很高效地走向错误方向;如果验收标准缺失,它也可能把“命令没报错”当成“用户问题已经解决”。所以,越是能执行的 AI,越需要人把“为什么做、做到什么程度、哪些不能做”讲清楚。
## 12. 结尾:从会提问,到会定义结果
也许未来真正重要的能力,不是记住多少命令,也不是一个人能写多少行代码。
而是:你能不能把一个模糊的想法,清楚地描述成一个可以执行、可以检查、也可以安全停止的目标。
因为当 AI 开始真正拥有执行能力之后,人类最重要的工作,会越来越集中在两个问题上:
**我们到底想做什么?**
以及:
**什么样的结果才是好的?**
Codex 的价值不只在于帮我们写代码,而在于把目标、工具、反馈和验证连成一条路。它不替我们承担所有判断,但可以让一个想法更快地走过“我知道该怎么做”,真正抵达“这件事已经被完成并且验证过”。
